

Dans le sillage du développement des smartphones, puis des offres de streaming musical ces dix dernières années, l’audio a pris une place importante dans les usages numériques. Ces nouvelles pratiques s’appliquent aussi à l’information. Les éditeurs s’y sont adaptés via différents formats et supports : podcasts de replay, podcasts natifs, enceintes connectées, et, depuis trois ans, lecture vocale automatisée de leurs articles en ligne, ou “text-to-speech”. Soit la capacité à transformer en contenu audio un article textuel.
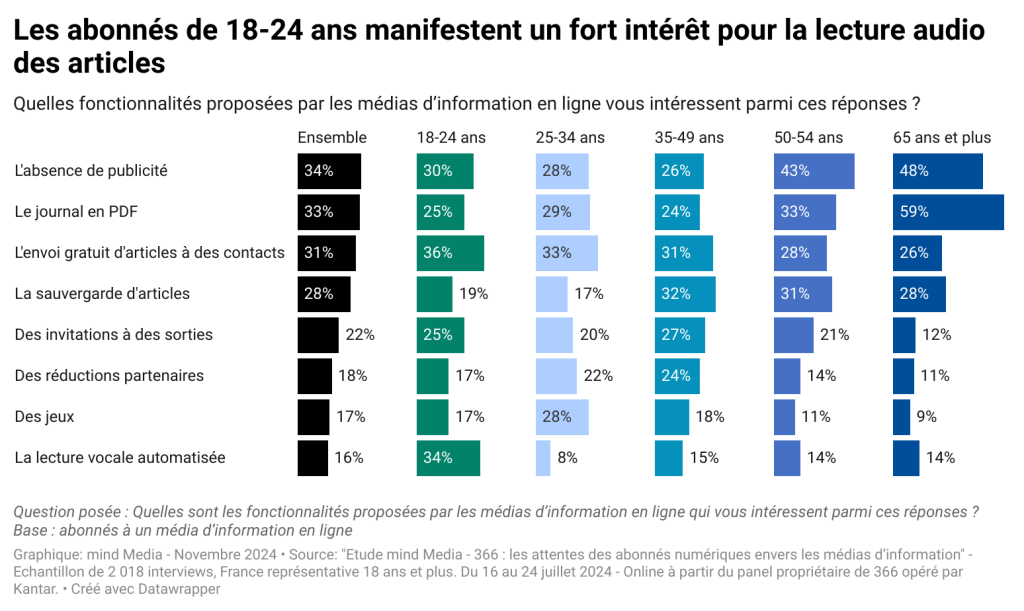
La lecture vocale automatisée des articles de presse est d’ailleurs fortement valorisée par les jeunes audiences, une cible que les médias ont du mal à toucher et à engager sur la durée. 34 % des Français âgés de 18 à 24 ans actuellement abonnés à un ou plusieurs médias d’information expriment ainsi un intérêt marqué pour la fonctionnalité (16 % pour l’ensemble de la population), selon notre étude sur les attentes des Français envers les abonnements en ligne, réalisée avec 366 et Kantar, et publiée en novembre dernier.
Lors de notre précédent benchmark en juillet 2023, nous avions identifié plusieurs solutions de text-to-speech utilisées en France. 18 mois plus tard, l’outil Remixd, proposée par le groupe britannique Global Player et alors employé sur le site Numerama, ne l’est plus.
Un nouvel acteur est en revanche apparu : Edisound, solution de la régie publicitaire audio éponyme, fondée en 2021 par Reworld Media avec Julien Mosse et François Pacot, qui a lancé son offre de text-to-speech à la fin du printemps 2023. Edisound a ainsi rejoint Podle, Odia, ETX Majelan, Audion, et Saooti. Tous sont français.
Deux types de stratégie
Tous ces acteurs font reposer leurs solutions sur les grands modèles de voix pour le text-to-speech proposés sur étagère par les grandes plateformes technologiques (Microsoft, Amazon et Google). Les fournisseurs d’IA générative peuvent cependant représenter une alternative parfois plus performante.